Plattform · Die Methode
Wie die Fragen entstehen, die wir messen
Jedes Werkzeug für KI-Sichtbarkeit misst Antworten. Der Unterschied liegt in den Fragen: wer sie schreibt, wie sie formuliert sind und nach welchem Kriterium man entscheidet, dass dieses Set einen Markt abbildet. Es ist die einzige Achse, auf der wir uns sachlich messen lassen.
Kurz gesagt
BIKMA schreibt keine Keywords in Fragen um. Es baut das Prompt-Set aus der wissenschaftlichen Literatur zum Informationsverhalten und zum Verhalten generativer Modelle, bildet jede Absicht mit mehreren Formulierungen ab und gewichtet jede Frage mit einem statistischen Inferenzmodell, das mit der Universität Pisa validiert wurde. Heraus kommt eine offengelegte Wahrscheinlichkeit, kein beobachtetes Volumen.
Ist das Set der Fragen willkürlich, ist jede Zahl darauf willkürlich. Deshalb veröffentlichen wir das Kriterium, nach dem die Fragen entstehen, und die Belege, auf denen es beruht.
Was uns von den anderen Werkzeugen unterscheidet
Der erste Punkt ist, woher die Fragen kommen. Manche Werkzeuge gehen von Google-Suchdaten aus und geben sie als Gespräche mit der KI aus: Das ist nicht dasselbe. Andere nutzen Panels beobachteter Nutzer, die gut funktionieren, aber fast nur auf Englisch und in den größten Märkten existieren: außerhalb davon, in anderen Sprachen, im B2B und in vertikalen Nischen, fällt die Abdeckung auf null. BIKMA rekonstruiert die Fragen daraus, wie Menschen online tatsächlich sprechen, mit veröffentlichter Methode. Es ist eine Schätzung, und das sagen wir offen — aber sie deckt genau das ab, was kein Panel sieht.
Der zweite Punkt ist, wie das Set gebaut wird. Mehrere Fassungen derselben Frage statt einer, Markenfragen getrennt von Kategoriefragen, Fragen in der Sprache des Marktes statt aus einem englischen Set übersetzt, Vergleiche bei gleichen Spezifikationen, damit die bekannteste Marke nicht von vornherein belohnt wird, und für kleine Marken ein anderer Indikator: nicht, wie oft sie im Schnitt erscheinen, sondern ob sie es überhaupt schaffen, bei irgendeiner Art von Frage zu erscheinen. Jede Entscheidung stammt aus einer veröffentlichten Studie, nicht aus einer Vorliebe von uns.
Der dritte Punkt ist, dass sich all das überprüfen lässt. Wir veröffentlichen, wie wir das Set bauen, wie wir die Kennzahl berechnen und wo sie falsch liegt. Die Methode wurde mit der Universität Pisa validiert und auf der The Web Conference zitiert. Wer von einem «proprietären Modell» spricht, ohne es zu zeigen, bittet Sie um Vertrauen; wir bitten Sie, die Methode zu lesen.
Wie Sie fragen zählt mehr als wie oft Sie fragen
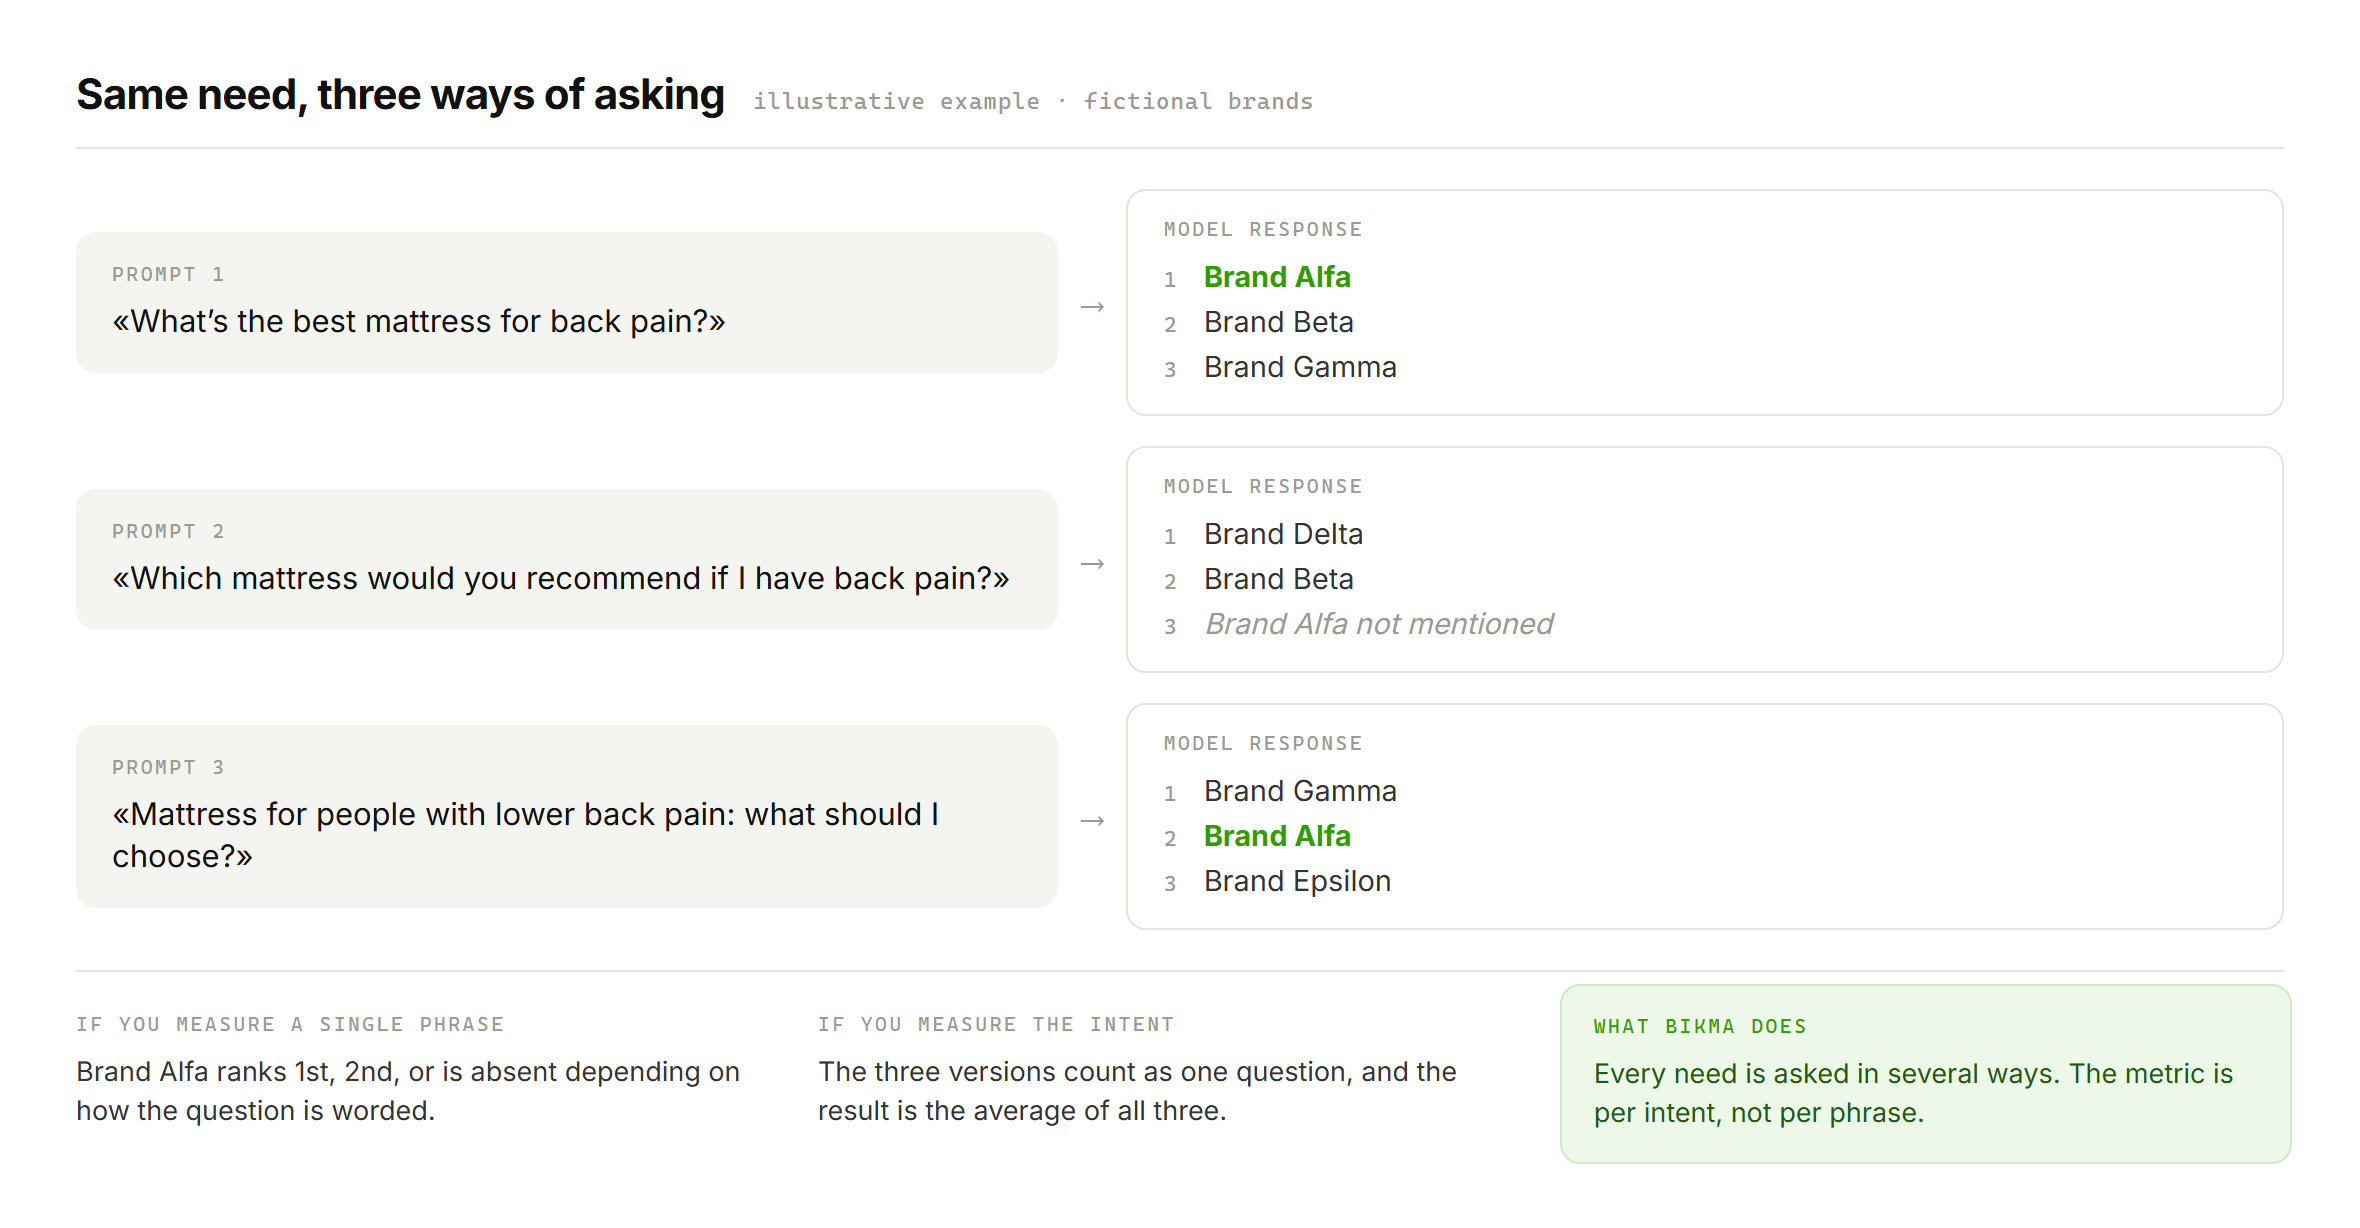
Der häufigste Einwand gegen Werkzeuge für KI-Sichtbarkeit lautet, die Modelle gäben jedes Mal andere Antworten. Das stimmt nur zum Teil. Die Forschung zeigt: Die Antwort ändert sich weit stärker, wenn man die Frage in andere Worte fasst, als wenn man genau dieselbe Frage zweimal stellt. Praktisch heißt das: „Welche Matratze ist die beste bei Rückenschmerzen“ und „Welche Matratze würden Sie mir empfehlen, wenn ich Rückenschmerzen habe“ können verschiedene Marken zurückgeben, obwohl sie dasselbe fragen.
Die Folge ist einfach. Wer einen Markt mit nur einer Fassung je Frage misst, misst nicht den Markt: Er misst diesen einen Satz. Deshalb nutzt BIKMA mehrere Fassungen derselben Frage und fasst das Ergebnis nach Absicht zusammen, nicht nach einzelnem Satz. Wie die Fragen entstehen, ist kein technisches Detail: Es ist die Messung selbst.
Was die Wissenschaft sagt
Die Belege, die den Entwurf des Prompt-Sets leiten. Peer-reviewed, wo angegeben; Preprints für die wesentlichen Befunde auf arXiv überprüft.
| Befund | Studie | Was er für die Messung bedeutet |
|---|---|---|
| Die Wirksamkeit der Sichtbarkeitshebel ändert sich mit der Anfragekategorie: direkte Zitate +27,8 %, Statistiken +25,9 %, Keyword-Stuffing −17,8 % über 10.000 Anfragen | GEO: Aggarwal et al., KDD 2024 (peer-reviewed, arXiv:2311.09735) | Das Set muss nach Nachfrage-Cluster gezogen werden: Ein Mittelwert über den ganzen Markt verdeckt gegenläufige Effekte |
| Wiedererkennung und Entdeckung sind verschiedene Phänomene: ChatGPT erkennt 99,4 % der Start-ups, wenn sie genannt werden, nennt sie aber nur bei 3,32 % der Entdeckungsanfragen | Discovery Gap (Preprint, arXiv:2601.00912) | Branded- und Non-Branded-Prompts müssen getrennt gemessen und nicht zu einem einzigen Sichtbarkeitsindex addiert werden |
| Eine Anfrage in der Sprache des Marktes hebt den Empfehlungsanteil lokaler Champions um +0,80, gegenüber +0,15 bei multinationalen Marken (35.640 Antworten, 12 europäische Sprachen) | Language Blind Spot (Preprint, arXiv:2606.23165) | Ein auf Englisch durchgeführtes Audit unterschätzt lokale Marken systematisch: native Prompts je Sprache sind eine methodische Notwendigkeit |
| LLMs verbinden globale Marken mit positiven Eigenschaften und drängen lokale an den Rand; bei gleichen Spezifikationen gewinnt die bekannte Marke in 100 % der Fälle | «Global is Good, Local is Bad», EMNLP 2024 (peer-reviewed, arXiv:2406.13997); Incumbent Advantage (arXiv:2606.17443) | Es braucht Prompts «bei gleichen Spezifikationen» und mit qualitativen Vorgaben, sonst misst man vorhandene Bekanntheit |
| Sichtbarkeit ist zweigipflig: Marken der Stufen 1–2 erscheinen fast immer, während 48–52 % der Stufen 4–5 nie erscheinen (37.000 Durchläufe) | Reachability (Preprint, arXiv:2605.27439) | Für Long-Tail-Marken ist die nützliche KPI die Erreichbarkeit (Erscheinen bei mindestens einer Fragenfamilie), nicht die durchschnittliche Häufigkeit |
| Die Übereinstimmung der Modelle bei der meistzitierten Marke liegt bei 41,6 %; bei 8 % der Anfragen dominiert keine Marke | Cross-model disagreement (Preprint, arXiv:2606.23057) | Monitoring über mehrere Modelle ist keine Dopplung: Es ist der einzige Weg, die leeren Stellen zu finden |
| Generative Suchmaschinen bevorzugen systematisch Drittquellen gegenüber den Inhalten der Marke | Earned-media bias (Preprint, arXiv:2509.08919) | Zitierte Quellen müssen als eigene Dimension gemessen werden: die eigene Website ist nicht der wichtigste Hebel |
| Das Consideration Set von Menschen umfasst bei Konsumgütern 2–4 Marken | Hauser & Wernerfelt, JCR 1990 (peer-reviewed) | Eine Antwort mit fünf Marken hat das mentale Set bereits gesättigt: Die Position zählt mehr als die Präsenz |
| Priming verändert die Wahl, ohne die Bewertung der Marke zu verändern | Nedungadi, JCR 1990 (peer-reviewed) | Zitiert werden ≠ bevorzugt werden: Nennung und Sentiment müssen getrennt gemessen werden |
| Der Nutzungskontext ordnet die mentale Kategorie und die Erinnerung neu (zielabgeleitete Kategorien) | Barsalou; Ratneshwar & Shocker, JMR 1991 (peer-reviewed) | Anlassbezogene Prompts fragen andere Markensets ab als Kategoriefragen: Sie sind eine eigene Achse |
| KI-Empfehlungen werden bei utilitaristischen Eigenschaften bevorzugt und bei hedonistischen abgelehnt | Word-of-Machine: Longoni & Cian, Journal of Marketing 2022 (peer-reviewed) | Erwartungen justieren: Generative Empfehlung wiegt in utilitaristischen Branchen schwerer |
| Traffic unter 0,2 % des Gesamtvolumens, aber ein 4,6-facher Effekt bei Produkten hoher Komplexität (973 Websites, 50 Tsd. Transaktionen) | Kaiser & Schulze, Marketing Science 2026 (peer-reviewed) | Der Wert des Monitorings bündelt sich in komplexen Kategorien, nicht im Volumen der Sitzungen |
Wie sich das in unserem Prompt-Set niederschlägt
-
01 · Theoretische Grundlage
Die Literatur zum Informationsverhalten in der Branche definiert die Bedarfsfamilien: Kategorie, Nutzungsanlass, Vergleich, Budgetgrenze, Rückversicherung.
-
02 · Tatsächliches öffentliches Gespräch
Foren, Communities, Bewertungen und Social Media liefern die Formulierungen, die der Markt für diese Bedarfe wirklich nutzt. Kein Keyword, das als Frage umgeschrieben wurde.
-
03 · Mehrere Formulierungen je Absicht
Jede Absicht wird mit mehreren Varianten abgebildet, auch mit vorgabe- und personenbezogenen Fassungen, und die Kennzahl wird auf der Absicht zusammengefasst.
-
04 · Gewichtung und Cluster
Der Prompt Probability Index weist jeder Frage ihre geschätzte Wahrscheinlichkeit in diesem Markt und Zeitraum zu, mit offengelegter Fehlermarge.
Häufige Fragen
Wörtlich aus den überwachten Prompts übernommen. FAQPage-Schema.
Warum kein Panel echter Gespräche?
Weil kein Panel die Nachfrage auf Italienisch, in engen B2B-Nischen und in kleinen Märkten abdeckt. Wo ein Panel beobachtet, sind beobachtete Daten besser; wo nicht, ist die Alternative keine schlechteren Daten, sondern gar keine.
Wie viele Prompts braucht ein Markt?
Das hängt von der Breite ab: In der Regel decken 60–120 gut gewählte Prompts eine B2B-Nische ab, ein Konsumgütermarkt braucht deutlich mehr. Es zählt die Abdeckung der Bedarfsfamilien, nicht die absolute Zahl.
Sind die zitierten Papers alle peer-reviewed?
Nein, und das sagen wir: Die Arbeiten in diesem Feld sind überwiegend jung und noch Preprints. Die Tabelle unterscheidet beides, und die wesentlichen Befunde aus Preprints sind auf arXiv überprüft.
Kann ich eigene Fragen hinzufügen?
Ja. Das Set ist änderbar, und jede von Hand hinzugefügte Frage bleibt als solche gekennzeichnet, damit sie die Zeitreihe nicht verfälscht.
Testen Sie es mit Ihren eigenen Daten
Starten Sie die 7-tägige kostenlose Testphase selbst (Karte erforderlich, kein Gespräch nötig): Sehen Sie Ihre echten Daten, bevor Sie sich für einen Tarif entscheiden.