Piattaforma · Il metodo
Come nascono le domande che misuriamo
Tutti i tool di AI visibility misurano risposte. La differenza sta nelle domande: chi le scrive, come le formula e con quale criterio decide che quel set rappresenta un mercato. È l’unico asse su cui competiamo sul merito.
In breve
BIKMA non riscrive keyword in forma interrogativa. Costruisce il prompt set a partire dalla letteratura scientifica sul comportamento informativo e sul comportamento dei modelli generativi, campiona ogni intento con più formulazioni e pesa ciascuna domanda con un modello di inferenza statistica validato con l’Università di Pisa. La metrica che ne esce è una probabilità dichiarata, non un volume osservato.
Se il set di domande è arbitrario, ogni numero costruito sopra è arbitrario. Per questo pubblichiamo il criterio con cui le domande nascono, e le evidenze su cui si basa.
Cosa ci differenzia dagli altri tool
Il primo punto è da dove arrivano le domande. Alcuni tool partono dai dati di ricerca su Google e li presentano come conversazioni con l’AI: non è la stessa cosa. Altri usano panel di utenti osservati, che funzionano bene ma esistono quasi solo in inglese e sui mercati più grandi: fuori da lì, nelle altre lingue, nel B2B e nelle nicchie verticali, la copertura si azzera. BIKMA ricostruisce le domande dal modo in cui le persone parlano davvero online, con un metodo pubblicato. È una stima, e lo diciamo apertamente, ma copre proprio ciò che nessun panel vede.
Il secondo punto è come è costruito il set. Più versioni della stessa domanda invece di una sola, domande sul brand tenute separate da quelle di categoria, domande scritte nella lingua del mercato e non tradotte da un set inglese, confronti a parità di caratteristiche per non premiare solo la marca più famosa, e per i brand piccoli un indicatore diverso: non quante volte compaiono in media, ma se riescono a comparire almeno su qualche tipo di domanda. Ogni scelta nasce da uno studio pubblicato, non da una preferenza nostra.
Il terzo punto è che tutto è verificabile. Pubblichiamo come costruiamo il set, come calcoliamo la metrica e dove sbaglia. Il metodo è stato validato con l’Università di Pisa e citato a The Web Conference. Chi parla di «modello proprietario» senza mostrarlo ti chiede fiducia; noi ti chiediamo di leggere il metodo.
Conta più come chiedi che quante volte chiedi
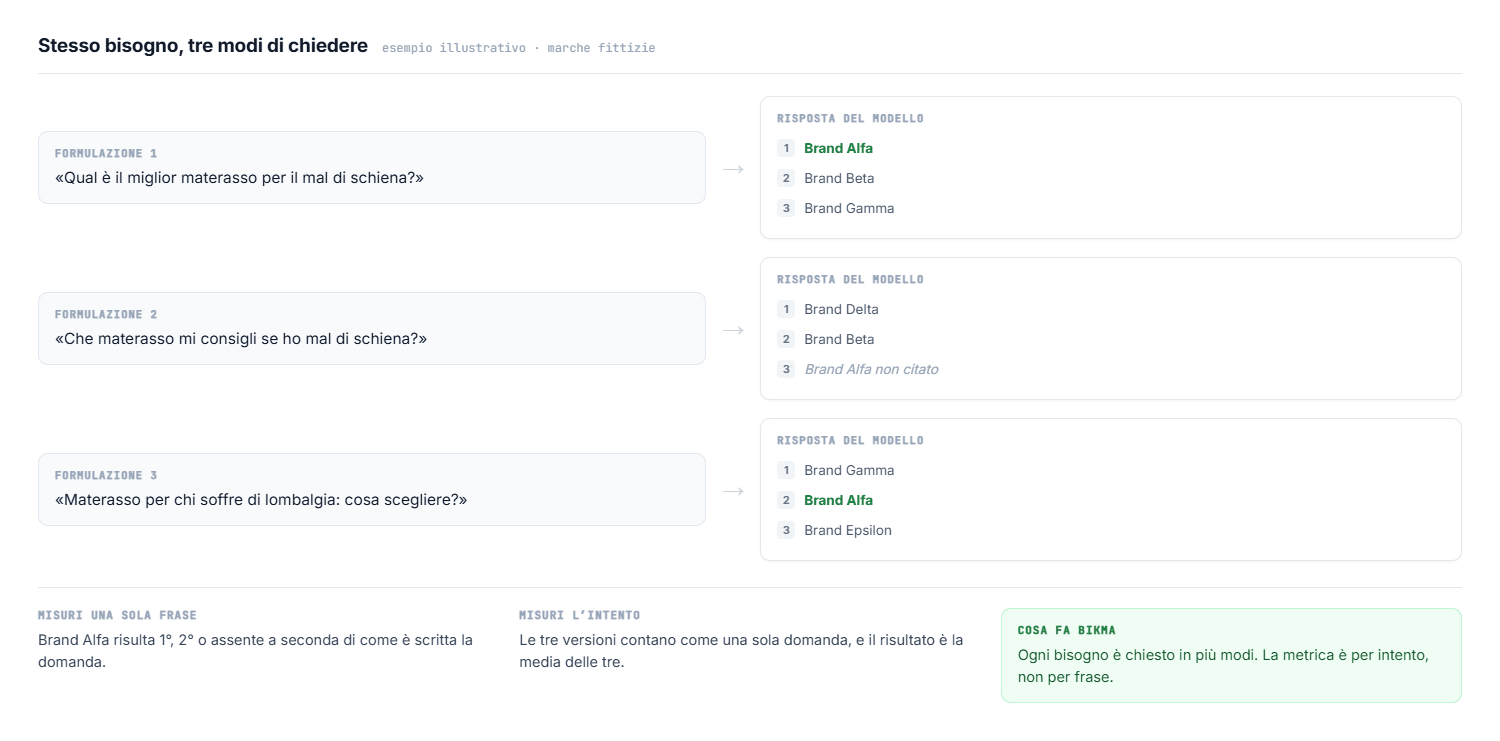
L’obiezione più comune ai tool di AI visibility è che i modelli danno risposte diverse ogni volta. È vero solo in parte. La ricerca mostra che cambia molto di più la risposta se riformuli la domanda con altre parole, rispetto a ripetere due volte la stessa identica domanda. In pratica: "qual è il miglior materasso per il mal di schiena" e "che materasso mi consigli se ho mal di schiena" possono restituire marche diverse, anche se chiedono la stessa cosa.
La conseguenza è semplice. Se misuri un mercato con una sola versione di ogni domanda, non stai misurando il mercato: stai misurando quella frase. Per questo BIKMA usa più versioni della stessa domanda e somma il risultato per intento, non per singola frase. Come nascono le domande non è un dettaglio tecnico: è la misura stessa.
Cosa dice la scienza
Le evidenze che guidano il disegno del prompt set. Peer-reviewed dove indicato, preprint verificati su arXiv per i finding chiave.
| Evidenza | Studio | Cosa implica per la misurazione |
|---|---|---|
| L’efficacia delle leve di visibilità varia per categoria di query: citazioni dirette +27,8%, statistiche +25,9%, keyword stuffing −17,8% su 10.000 query | GEO: Aggarwal et al., KDD 2024 (peer-reviewed, arXiv:2311.09735) | Il set va campionato per cluster di domanda: una media su tutto il mercato nasconde effetti opposti |
| Riconoscimento e scoperta sono fenomeni diversi: ChatGPT riconosce il 99,4% delle startup se nominate, ma le fa emergere solo nel 3,32% delle query di scoperta | Discovery Gap (preprint, arXiv:2601.00912) | Prompt brand e no-brand vanno misurati separatamente, non sommati in un unico indice di visibilità |
| Interrogare nella lingua del mercato alza la recommendation share di +0,80 per i campioni locali, contro +0,15 per le multinazionali (35.640 risposte, 12 lingue europee) | Language Blind Spot (preprint, arXiv:2606.23165) | Un audit condotto in inglese sottostima sistematicamente i brand locali: i prompt nativi in italiano sono una necessità metodologica |
| Gli LLM associano i brand globali ad attributi positivi e marginalizzano quelli locali; a specifiche identiche il brand noto vince nel 100% dei casi | «Global is Good, Local is Bad», EMNLP 2024 (peer-reviewed, arXiv:2406.13997); Incumbent Advantage (arXiv:2606.17443) | Servono prompt «a parità di specifiche» e con vincoli qualitativi, altrimenti si misura la notorietà pregressa |
| La visibilità è bimodale: i brand tier 1–2 emergono quasi sempre, il 48–52% dei tier 4–5 non emerge mai (37.000 run) | Reachability (preprint, arXiv:2605.27439) | Per i brand long-tail il KPI utile è la raggiungibilità (emerge almeno su una famiglia di prompt), non la frequenza media |
| L’accordo tra modelli sul brand più citato è del 41,6%; nell’8% delle query nessun brand domina | Cross-model disagreement (preprint, arXiv:2606.23057) | Il monitoraggio multi-modello non è ridondanza: è l’unico modo di individuare gli spazi vuoti |
| I motori generativi privilegiano sistematicamente le fonti terze rispetto ai contenuti brand-owned | Earned-media bias (preprint, arXiv:2509.08919) | Le fonti citate vanno misurate come dimensione autonoma: il proprio sito non è la leva principale |
| I set di considerazione umani nei beni di consumo contano 2–4 brand | Hauser & Wernerfelt, JCR 1990 (peer-reviewed) | Una risposta che elenca cinque brand ha già saturato il set mentale: la posizione conta più della presenza |
| Il priming cambia la scelta senza cambiare la valutazione del brand | Nedungadi, JCR 1990 (peer-reviewed) | Essere citati ≠ essere preferiti: menzione e sentiment vanno misurati separatamente |
| Il contesto d’uso ristruttura la categoria mentale e il recall (categorie goal-derived) | Barsalou; Ratneshwar & Shocker, JMR 1991 (peer-reviewed) | I prompt legati all’occasione interrogano set di brand diversi da quelli di categoria: sono un asse a sé |
| Le raccomandazioni AI sono preferite sugli attributi utilitaristici e rifiutate su quelli edonici | Word-of-Machine: Longoni & Cian, Journal of Marketing 2022 (peer-reviewed) | Calibra le attese: la raccomandazione generativa pesa di più nei verticali utilitaristici |
| Traffico sotto lo 0,2% del totale, ma effetto 4,6x sui prodotti ad alta complessità (973 siti, 50k transazioni) | Kaiser & Schulze, Marketing Science 2026 (peer-reviewed) | Il valore del monitoraggio si concentra sulle categorie complesse, non sul volume di sessioni |
Come si traduce nel nostro prompt set
-
01 · Base teorica
La letteratura sul comportamento informativo del settore definisce le famiglie di domanda: categoria, occasione d’uso, confronto, vincolo di budget, rassicurazione.
-
02 · Discorso pubblico reale
Forum, community, recensioni e social forniscono le espressioni effettive con cui il mercato formula quei bisogni. Nessuna keyword riscritta come domanda.
-
03 · Multi-formulazione per intento
Ogni intento viene campionato con più varianti, comprese le versioni con vincolo e con persona, e la metrica è aggregata sull’intento.
-
04 · Ponderazione e cluster
L’Indice di Probabilità del Prompt assegna a ogni domanda la sua probabilità stimata nel mercato e nel periodo, con margine di errore dichiarato.
Domande frequenti
Riprese letteralmente dai prompt monitorati. Schema FAQPage.
Perché non usate un panel di conversazioni reali?
Perché non esiste un panel con copertura sulla domanda in lingua italiana, sui verticali B2B stretti e sui mercati piccoli. Dove il panel osserva, il dato osservato è migliore; dove non osserva, l’alternativa non è un dato peggiore, è nessun dato.
Quanti prompt servono per un mercato?
Dipende dall’ampiezza: tipicamente 60–120 prompt ben scelti coprono un verticale B2B, molti di più un mercato consumer. Conta la copertura delle famiglie di domanda, non il numero assoluto.
I paper citati sono tutti peer-reviewed?
No, e lo segnaliamo: i lavori su questo dominio sono in larga parte recenti e ancora in preprint. La tabella distingue le due condizioni, e i finding chiave dei preprint sono verificati su arXiv.
Posso aggiungere domande mie?
Sì. Il set è editabile e ogni domanda aggiunta manualmente resta tracciata come tale, per non contaminare la serie storica.
Come funziona il metodo
-
Come identifichiamo le domande
Il perimetro di misurazione non si estrae da uno strumento di keyword research: si costruisce.
-
L’Indice di Probabilità del Prompt
Una metrica con un nome proprio, una definizione formale e una scala dichiarata.
-
Da dove viene il segnale
Il discorso pubblico reale è l’input del modello. Queste sono le classi di fonte che usiamo.
-
Validazione scientifica
Otto anni di collaborazione di ricerca, un paper citato a The Web Conference, oltre 200 progetti enterprise.
-
Limiti e margine di errore
Nessuno nella categoria pubblica i limiti del proprio metodo. Questa pagina esiste per quello.
Provala sui tuoi dati
Attivi la prova gratuita di 7 giorni in autonomia, con carta e senza call: vedi i tuoi dati reali prima di scegliere un piano.