Plateforme · La méthode
Comment naissent les questions que nous mesurons
Tous les outils d’AI visibility mesurent des réponses. La différence tient aux questions : qui les écrit, comment elles sont formulées et selon quel critère on décide que cet ensemble représente un marché. C’est le seul axe sur lequel nous nous mesurons sur le fond.
En bref
BIKMA ne se contente pas de reformuler des mots-clés en questions. Il construit le prompt set à partir de la littérature scientifique sur le comportement informationnel et sur le comportement des modèles génératifs, échantillonne chaque intention avec plusieurs formulations et pondère chaque question à l’aide d’un modèle d’inférence statistique validé avec l’Université de Pise. Le résultat est une probabilité déclarée, pas un volume observé.
Si l’ensemble des questions est arbitraire, chaque chiffre construit dessus l’est aussi. C’est pourquoi nous publions le critère selon lequel naissent les questions, et les preuves sur lesquelles il repose.
Ce qui nous distingue des autres outils
Le premier point, c’est l’origine des questions. Certains outils partent des données de recherche Google et les présentent comme des conversations avec l’IA : ce n’est pas la même chose. D’autres utilisent des panels d’utilisateurs observés, qui fonctionnent bien mais n’existent presque qu’en anglais et sur les plus grands marchés : au-delà, dans les autres langues, en B2B et dans les niches verticales, la couverture tombe à zéro. BIKMA reconstitue les questions à partir de la façon dont les gens s’expriment réellement en ligne, avec une méthode publiée. C’est une estimation, et nous le disons ouvertement, mais elle couvre précisément ce qu’aucun panel ne voit.
Le deuxième point, c’est la construction de l’ensemble. Plusieurs versions d’une même question au lieu d’une seule, des questions de marque séparées des questions de catégorie, des questions rédigées dans la langue du marché et non traduites d’un set anglais, des comparaisons à caractéristiques égales pour ne pas récompenser d’office la marque la plus connue et, pour les petites marques, un autre indicateur : non pas combien de fois elles apparaissent en moyenne, mais si elles parviennent à apparaître sur au moins un type de question. Chaque choix découle d’une étude publiée, pas d’une préférence de notre part.
Le troisième point, c’est que tout est vérifiable. Nous publions comment nous construisons l’ensemble, comment nous calculons la métrique et où elle se trompe. La méthode a été validée avec l’Université de Pise et citée à The Web Conference. Ceux qui parlent de « modèle propriétaire » sans le montrer vous demandent de leur faire confiance ; nous vous demandons de lire la méthode.
La façon de demander compte plus que le nombre de fois
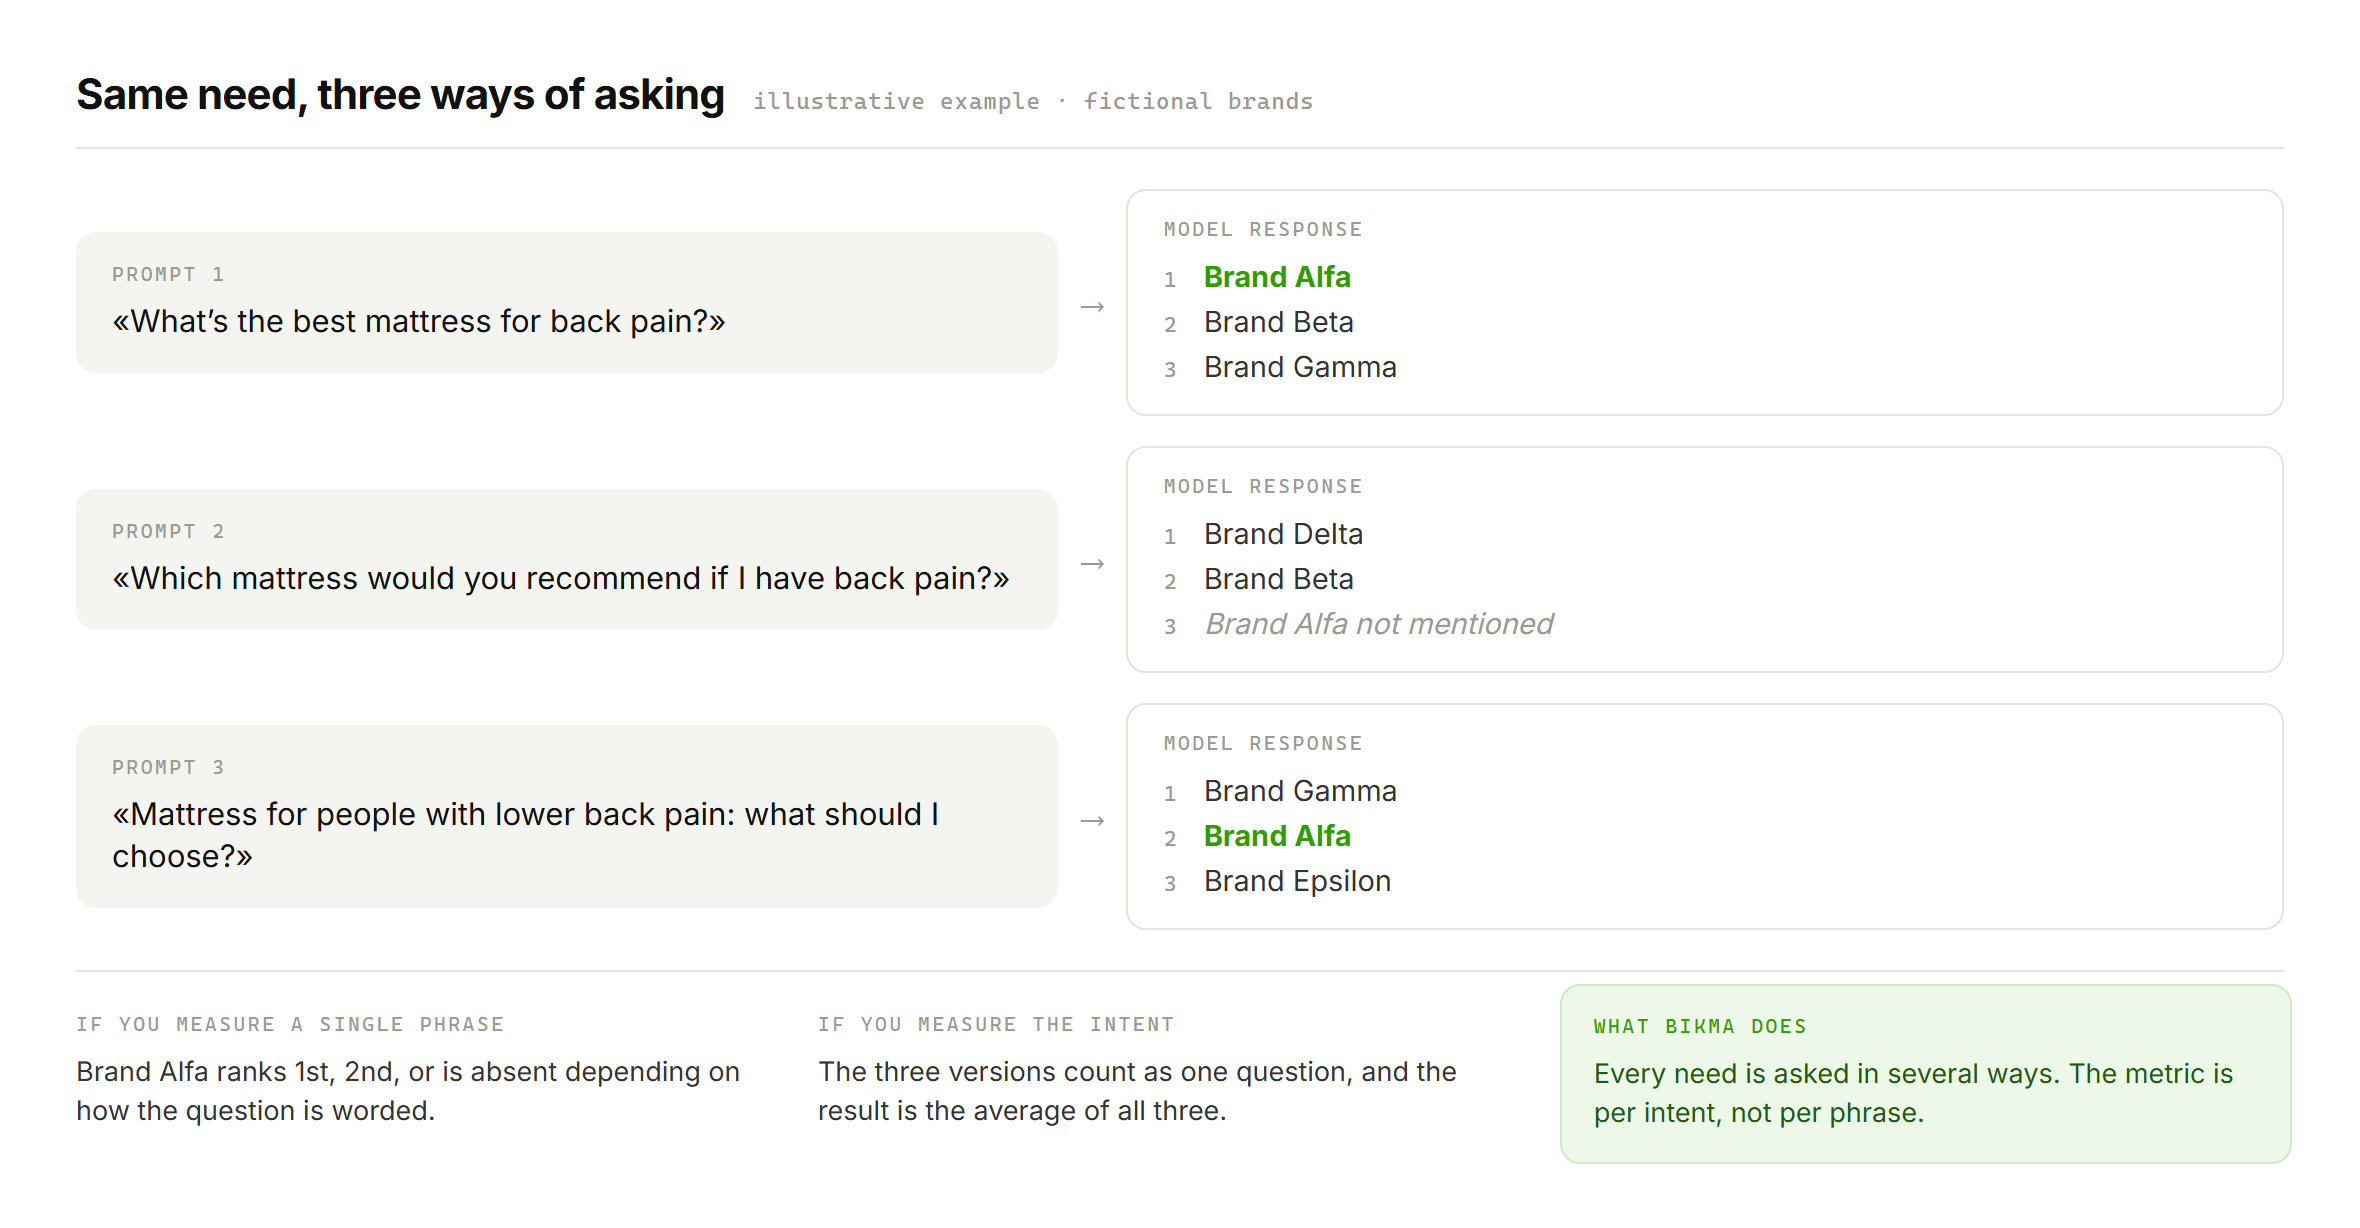
L’objection la plus courante aux outils d’AI visibility, c’est que les modèles donnent des réponses différentes à chaque fois. Ce n’est vrai qu’en partie. La recherche montre que la réponse change bien davantage quand on reformule la question avec d’autres mots que quand on répète deux fois exactement la même question. Concrètement : « quel est le meilleur matelas pour le mal de dos » et « quel matelas me conseillez-vous si j’ai mal au dos » peuvent faire ressortir des marques différentes, alors qu’elles demandent la même chose.
La conséquence est simple. Si vous mesurez un marché avec une seule version de chaque question, vous ne mesurez pas le marché : vous mesurez cette phrase. C’est pourquoi BIKMA utilise plusieurs versions de la même question et agrège le résultat par intention, pas par phrase. La façon dont naissent les questions n’est pas un détail technique : c’est la mesure elle-même.
Ce que dit la science
Les preuves qui guident la conception du prompt set. Évaluées par les pairs lorsque c’est indiqué ; prépublications vérifiées sur arXiv pour les résultats clés.
| Constat | Étude | Ce que cela implique pour la mesure |
|---|---|---|
| L’efficacité des leviers de visibilité varie selon la catégorie de requête : citations directes +27,8 %, statistiques +25,9 %, keyword stuffing −17,8 % sur 10 000 requêtes | GEO : Aggarwal et al., KDD 2024 (évalué par les pairs, arXiv:2311.09735) | L’ensemble doit être échantillonné par cluster de demande : une moyenne sur tout le marché masque des effets opposés |
| Reconnaissance et découverte sont des phénomènes distincts : ChatGPT reconnaît 99,4 % des startups quand on les nomme, mais ne les fait ressortir que dans 3,32 % des requêtes de découverte | Discovery Gap (prépublication, arXiv:2601.00912) | Les prompts de marque et hors marque doivent être mesurés séparément, et non additionnés dans un indice de visibilité unique |
| Interroger dans la langue du marché augmente la part de recommandation de +0,80 pour les champions locaux, contre +0,15 pour les multinationales (35 640 réponses, 12 langues européennes) | Language Blind Spot (prépublication, arXiv:2606.23165) | Un audit mené en anglais sous-estime systématiquement les marques locales : des prompts natifs dans chaque langue sont une nécessité méthodologique |
| Les LLM associent les marques mondiales à des attributs positifs et marginalisent les marques locales ; à caractéristiques identiques, la marque connue l’emporte dans 100 % des cas | « Global is Good, Local is Bad », EMNLP 2024 (évalué par les pairs, arXiv:2406.13997) ; Incumbent Advantage (arXiv:2606.17443) | Il faut des prompts « à caractéristiques égales » et avec des contraintes qualitatives, sinon on mesure la notoriété acquise |
| La visibilité est bimodale : les marques de tier 1–2 ressortent presque toujours, tandis que 48–52 % des marques de tier 4–5 ne ressortent jamais (37 000 exécutions) | Reachability (prépublication, arXiv:2605.27439) | Pour les marques de longue traîne, le KPI utile est l’atteignabilité (ressortir sur au moins une famille de prompts), pas la fréquence moyenne |
| L’accord entre modèles sur la marque la plus citée est de 41,6 % ; dans 8 % des requêtes, aucune marque ne domine | Cross-model disagreement (prépublication, arXiv:2606.23057) | Le suivi multimodèle n’est pas une redondance : c’est le seul moyen de repérer les espaces vides |
| Les moteurs génératifs privilégient systématiquement les sources tierces par rapport aux contenus propres à la marque | Earned-media bias (prépublication, arXiv:2509.08919) | Les sources citées doivent être mesurées comme une dimension à part entière : votre propre site n’est pas le levier principal |
| Dans les biens de consommation, les ensembles de considération humains comptent 2 à 4 marques | Hauser & Wernerfelt, JCR 1990 (évalué par les pairs) | Une réponse qui cite cinq marques a déjà saturé l’ensemble mental : la position compte plus que la présence |
| L’amorçage (priming) modifie le choix sans modifier l’évaluation de la marque | Nedungadi, JCR 1990 (évalué par les pairs) | Être cité ≠ être préféré : mention et sentiment doivent être mesurés séparément |
| Le contexte d’usage restructure la catégorie mentale et la mémorisation (catégories dérivées d’objectifs) | Barsalou ; Ratneshwar & Shocker, JMR 1991 (évalué par les pairs) | Les prompts liés à l’occasion d’usage interrogent d’autres ensembles de marques que ceux de catégorie : ils forment un axe à part |
| Les recommandations de l’IA sont préférées sur les attributs utilitaires et rejetées sur les attributs hédoniques | Word-of-Machine : Longoni & Cian, Journal of Marketing 2022 (évalué par les pairs) | Ajustez vos attentes : la recommandation générative pèse davantage dans les verticales utilitaires |
| Un trafic inférieur à 0,2 % du total, mais un effet multiplié par 4,6 sur les produits à forte complexité (973 sites, 50 000 transactions) | Kaiser & Schulze, Marketing Science 2026 (évalué par les pairs) | La valeur du suivi se concentre sur les catégories complexes, pas sur le volume de sessions |
Comment cela se traduit dans notre prompt set
-
01 · Base théorique
La littérature sur le comportement informationnel du secteur définit les familles de demande : catégorie, occasion d’usage, comparaison, contrainte de budget, réassurance.
-
02 · Conversation publique réelle
Forums, communautés, avis et réseaux sociaux fournissent les expressions réelles par lesquelles le marché formule ces besoins. Aucun mot-clé reformulé en question.
-
03 · Plusieurs formulations par intention
Chaque intention est échantillonnée avec plusieurs variantes, y compris des versions avec contrainte et avec persona, et la métrique est agrégée au niveau de l’intention.
-
04 · Pondération et clusters
Le Prompt Probability Index attribue à chaque question sa probabilité estimée sur ce marché et sur cette période, avec une marge d’erreur déclarée.
Questions fréquentes
Reprises mot pour mot des prompts suivis. Schéma FAQPage.
Pourquoi ne pas utiliser un panel de conversations réelles ?
Parce qu’aucun panel ne couvre la demande en italien, dans les verticales B2B étroites et sur les petits marchés. Là où un panel observe, la donnée observée est meilleure ; là où il n’observe pas, l’alternative n’est pas une donnée moins bonne, c’est l’absence de donnée.
Combien de prompts faut-il pour un marché ?
Cela dépend de son étendue : en général, 60 à 120 prompts bien choisis couvrent une verticale B2B, beaucoup plus pour un marché grand public. Ce qui compte, c’est la couverture des familles de demande, pas le nombre absolu.
Les articles cités sont-ils tous évalués par les pairs ?
Non, et nous le signalons : les travaux dans ce domaine sont en grande partie récents et encore en prépublication. Le tableau distingue les deux cas, et les résultats clés des prépublications sont vérifiés sur arXiv.
Puis-je ajouter mes propres questions ?
Oui. L’ensemble est modifiable et chaque question ajoutée manuellement reste signalée comme telle, pour ne pas contaminer la série historique.
Essayez-la sur vos données
Lancez vous-même l’essai gratuit de 7 jours (carte requise, sans appel) : voyez vos données réelles avant de choisir une offre.