Plataforma · El método
Cómo nacen las preguntas que medimos
Todas las herramientas de AI visibility miden respuestas. La diferencia está en las preguntas: quién las escribe, cómo las formula y con qué criterio decide que ese conjunto representa un mercado. Es el único eje en el que competimos por méritos.
En resumen
BIKMA no reescribe keywords en forma de pregunta. Construye el prompt set a partir de la literatura científica sobre el comportamiento informativo y sobre el comportamiento de los modelos generativos, muestrea cada intención con varias formulaciones y pondera cada pregunta con un modelo de inferencia estadística validado con la Universidad de Pisa. Lo que resulta es una probabilidad declarada, no un volumen observado.
Si el conjunto de preguntas es arbitrario, cada número que se construye encima es arbitrario. Por eso publicamos el criterio con el que nacen las preguntas y la evidencia en la que se apoya.
Qué nos diferencia de las demás herramientas
El primer punto es de dónde vienen las preguntas. Algunas herramientas parten de los datos de búsqueda de Google y los presentan como conversaciones con la IA: no es lo mismo. Otras usan paneles de usuarios observados, que funcionan bien pero existen casi solo en inglés y en los mercados más grandes: fuera de ahí, en otros idiomas, en el B2B y en los nichos verticales, la cobertura cae a cero. BIKMA reconstruye las preguntas a partir de cómo habla de verdad la gente en internet, con un método publicado. Es una estimación, y lo decimos abiertamente, pero cubre justo lo que ningún panel ve.
El segundo punto es cómo se construye el conjunto. Varias versiones de la misma pregunta en lugar de una sola, preguntas de marca separadas de las de categoría, preguntas escritas en el idioma del mercado y no traducidas de un conjunto en inglés, comparaciones a igualdad de características para no premiar por defecto a la marca más conocida y, para las marcas pequeñas, un indicador distinto: no cuántas veces aparecen de media, sino si consiguen aparecer al menos en algún tipo de pregunta. Cada decisión nace de un estudio publicado, no de una preferencia nuestra.
El tercer punto es que todo es verificable. Publicamos cómo construimos el conjunto, cómo calculamos la métrica y dónde se equivoca. El método se validó con la Universidad de Pisa y se citó en The Web Conference. Quien habla de «modelo propietario» sin enseñarlo te pide confianza; nosotros te pedimos que leas el método.
Importa más cómo preguntas que cuántas veces preguntas
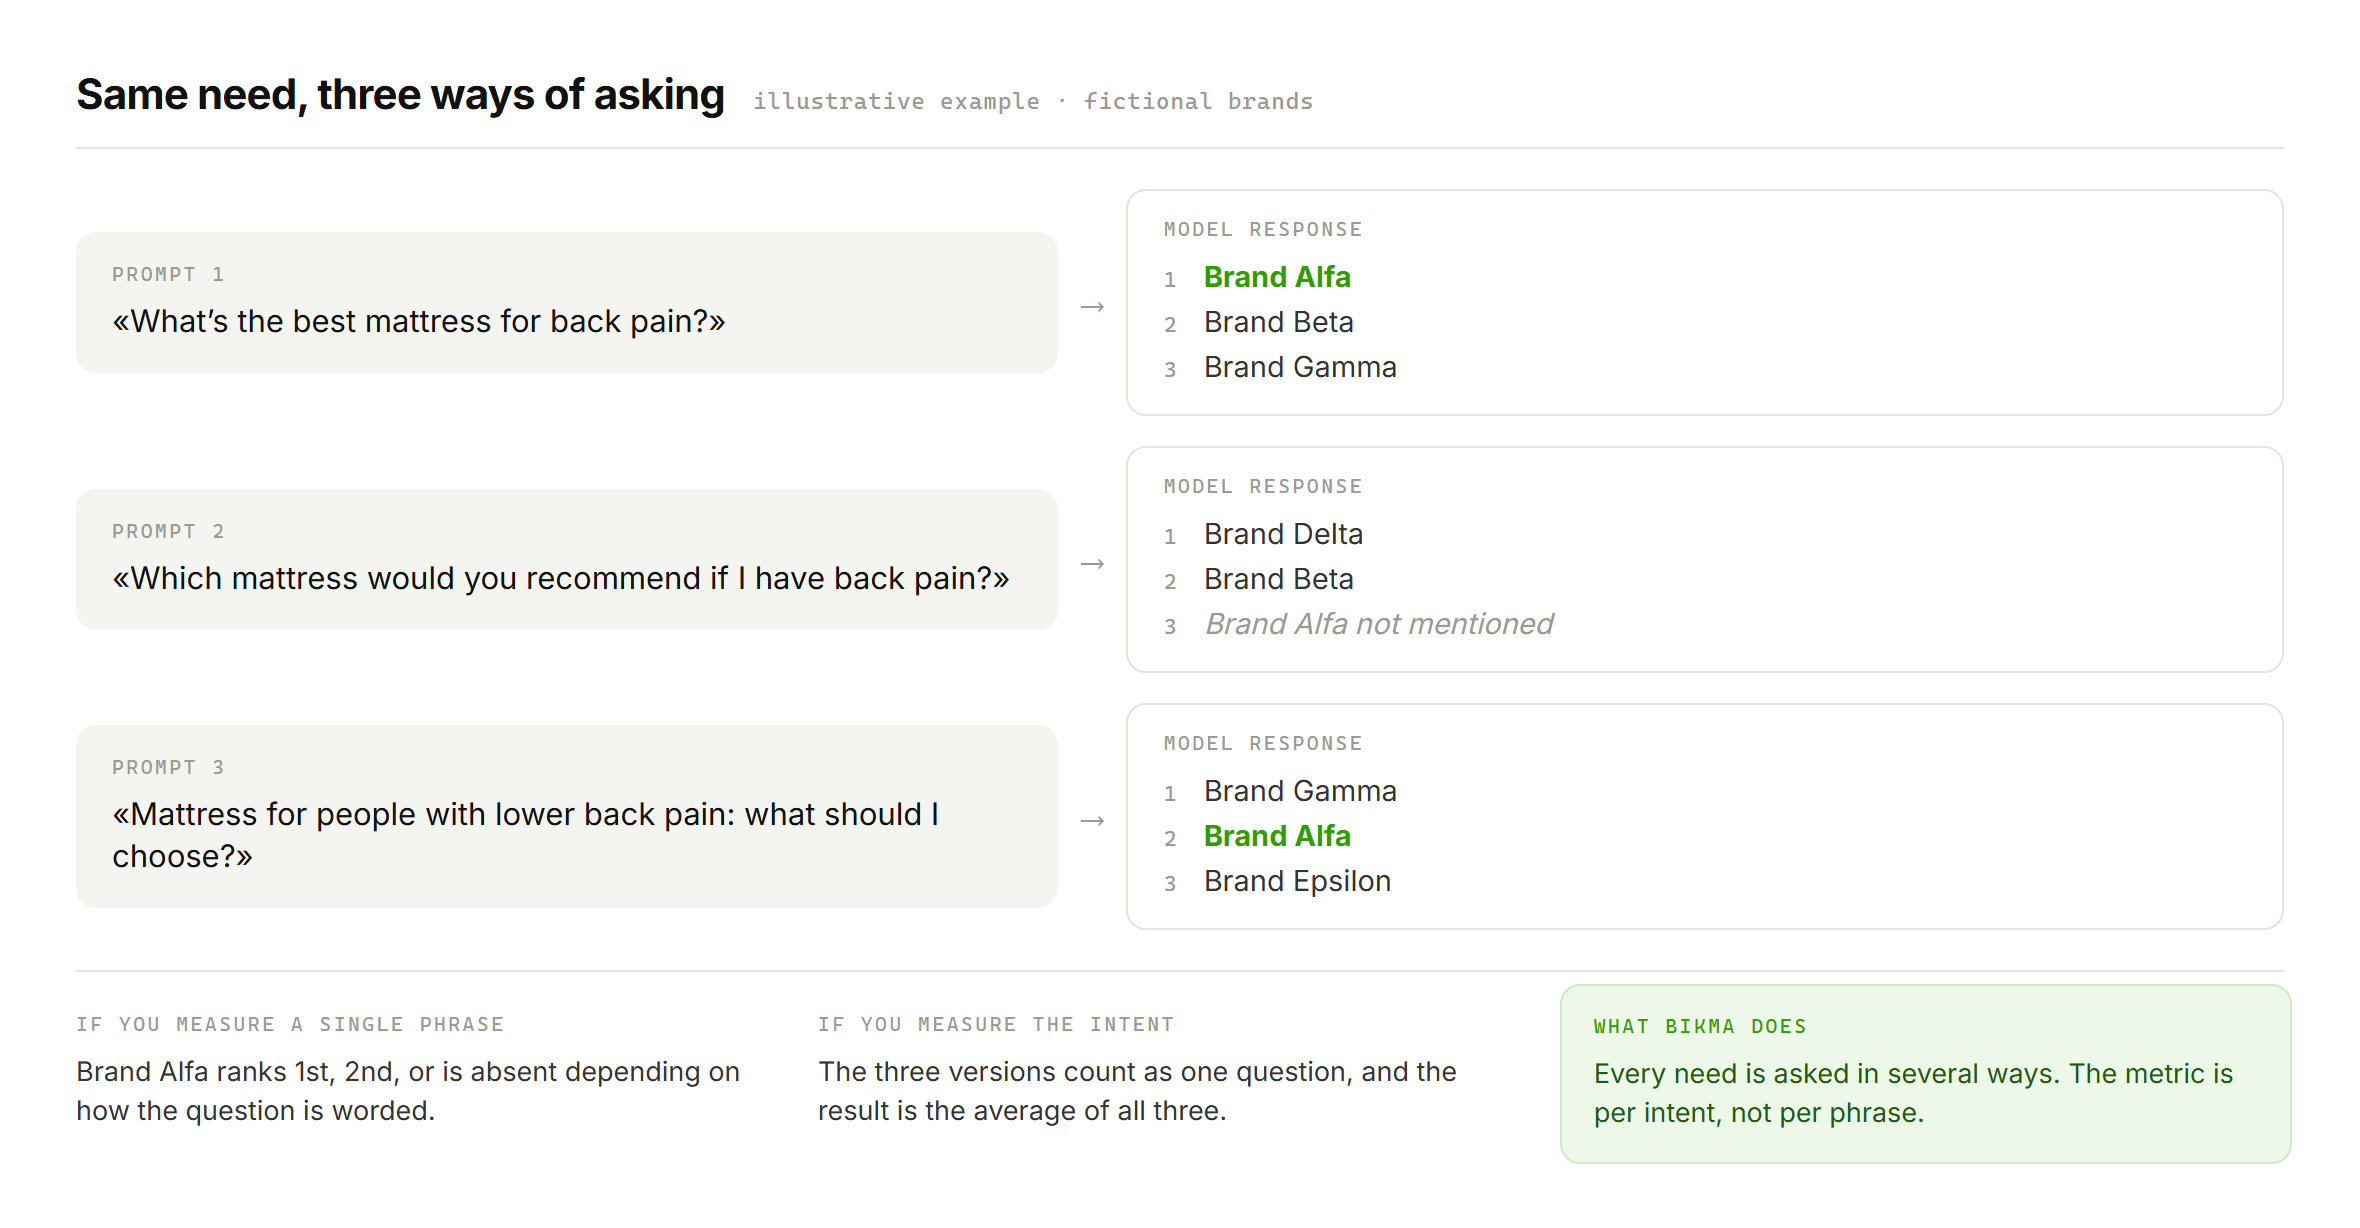
La objeción más habitual a las herramientas de AI visibility es que los modelos dan respuestas distintas cada vez. Solo es verdad en parte. La investigación muestra que la respuesta cambia mucho más si reformulas la pregunta con otras palabras que si repites dos veces exactamente la misma pregunta. En la práctica: «cuál es el mejor colchón para el dolor de espalda» y «qué colchón me recomiendas si me duele la espalda» pueden devolver marcas distintas, aunque pregunten lo mismo.
La consecuencia es sencilla. Si mides un mercado con una sola versión de cada pregunta, no estás midiendo el mercado: estás midiendo esa frase. Por eso BIKMA usa varias versiones de la misma pregunta y agrega el resultado por intención, no por frase. Cómo nacen las preguntas no es un detalle técnico: es la medición misma.
Qué dice la ciencia
La evidencia que guía el diseño del prompt set. Revisada por pares donde se indica; preprints verificados en arXiv para los hallazgos clave.
| Evidencia | Estudio | Qué implica para la medición |
|---|---|---|
| La eficacia de las palancas de visibilidad varía según la categoría de consulta: citas directas +27,8 %, estadísticas +25,9 %, keyword stuffing −17,8 % en 10.000 consultas | GEO: Aggarwal et al., KDD 2024 (revisado por pares, arXiv:2311.09735) | El conjunto debe muestrearse por cluster de demanda: una media sobre todo el mercado oculta efectos opuestos |
| Reconocimiento y descubrimiento son fenómenos distintos: ChatGPT reconoce el 99,4 % de las startups cuando se las nombra, pero solo las hace aparecer en el 3,32 % de las consultas de descubrimiento | Discovery Gap (preprint, arXiv:2601.00912) | Los prompts de marca y sin marca deben medirse por separado, no sumarse en un único índice de visibilidad |
| Preguntar en el idioma del mercado eleva la cuota de recomendación en +0,80 para los campeones locales, frente a +0,15 para las multinacionales (35.640 respuestas, 12 idiomas europeos) | Language Blind Spot (preprint, arXiv:2606.23165) | Una auditoría hecha en inglés subestima sistemáticamente a las marcas locales: los prompts nativos en cada idioma son una necesidad metodológica |
| Los LLM asocian las marcas globales a atributos positivos y marginan a las locales; con especificaciones idénticas, la marca conocida gana el 100 % de las veces | «Global is Good, Local is Bad», EMNLP 2024 (revisado por pares, arXiv:2406.13997); Incumbent Advantage (arXiv:2606.17443) | Hacen falta prompts «a igualdad de especificaciones» y con restricciones cualitativas; si no, se mide la notoriedad previa |
| La visibilidad es bimodal: las marcas de tier 1–2 aparecen casi siempre, mientras que el 48–52 % de las de tier 4–5 no aparece nunca (37.000 ejecuciones) | Reachability (preprint, arXiv:2605.27439) | Para las marcas de cola larga, el KPI útil es la alcanzabilidad (aparecer al menos en una familia de prompts), no la frecuencia media |
| El acuerdo entre modelos sobre la marca más citada es del 41,6 %; en el 8 % de las consultas ninguna marca domina | Cross-model disagreement (preprint, arXiv:2606.23057) | La monitorización multimodelo no es redundancia: es la única forma de encontrar los espacios vacíos |
| Los motores generativos favorecen sistemáticamente las fuentes de terceros frente al contenido propio de la marca | Earned-media bias (preprint, arXiv:2509.08919) | Las fuentes citadas deben medirse como una dimensión propia: tu propio sitio no es la palanca principal |
| Los conjuntos de consideración humanos en bienes de consumo contienen de 2 a 4 marcas | Hauser & Wernerfelt, JCR 1990 (revisado por pares) | Una respuesta que enumera cinco marcas ya ha saturado el conjunto mental: la posición importa más que la presencia |
| El priming cambia la elección sin cambiar la valoración de la marca | Nedungadi, JCR 1990 (revisado por pares) | Ser citado ≠ ser preferido: mención y sentiment deben medirse por separado |
| El contexto de uso reestructura la categoría mental y el recuerdo (categorías derivadas de objetivos) | Barsalou; Ratneshwar & Shocker, JMR 1991 (revisado por pares) | Los prompts ligados a la ocasión de uso consultan conjuntos de marcas distintos de los de categoría: son un eje propio |
| Las recomendaciones de la IA se prefieren en los atributos utilitarios y se rechazan en los hedónicos | Word-of-Machine: Longoni & Cian, Journal of Marketing 2022 (revisado por pares) | Ajusta las expectativas: la recomendación generativa pesa más en los verticales utilitarios |
| Tráfico por debajo del 0,2 % del total, pero un efecto de 4,6x en productos de alta complejidad (973 sitios, 50.000 transacciones) | Kaiser & Schulze, Marketing Science 2026 (revisado por pares) | El valor de la monitorización se concentra en las categorías complejas, no en el volumen de sesiones |
Cómo se traduce en nuestro prompt set
-
01 · Base teórica
La literatura sobre el comportamiento informativo del sector define las familias de demanda: categoría, ocasión de uso, comparación, restricción de presupuesto, tranquilidad.
-
02 · Conversación pública real
Foros, comunidades, reseñas y redes sociales aportan las expresiones reales con las que el mercado formula esas necesidades. Ninguna keyword reescrita como pregunta.
-
03 · Varias formulaciones por intención
Cada intención se muestrea con varias variantes, incluidas las versiones con restricción y con persona, y la métrica se agrega sobre la intención.
-
04 · Ponderación y cluster
El Prompt Probability Index asigna a cada pregunta su probabilidad estimada en ese mercado y periodo, con un margen de error declarado.
Preguntas frecuentes
Tomadas literalmente de los prompts monitorizados. Schema FAQPage.
¿Por qué no usáis un panel de conversaciones reales?
Porque ningún panel cubre la demanda en italiano, en verticales B2B estrechos y en mercados pequeños. Donde el panel observa, el dato observado es mejor; donde no observa, la alternativa no es un dato peor: es ningún dato.
¿Cuántos prompts necesita un mercado?
Depende de su amplitud: normalmente, 60–120 prompts bien elegidos cubren un vertical B2B, y muchos más un mercado de consumo. Lo que cuenta es la cobertura de las familias de demanda, no el número absoluto.
¿Los papers citados están todos revisados por pares?
No, y lo decimos: los trabajos en este ámbito son en gran parte recientes y siguen en preprint. La tabla distingue las dos condiciones, y los hallazgos clave de los preprints están verificados en arXiv.
¿Puedo añadir mis propias preguntas?
Sí. El conjunto es editable y cada pregunta añadida a mano queda marcada como tal, para no contaminar la serie histórica.
Pruébalo con tus datos
Activa tú mismo la prueba gratuita de 7 días, con tarjeta y sin llamada: ve tus datos reales antes de elegir un plan.